
导读
视频扩散模型把图像去噪扩展到时间维度,并研究图像与视频联合训练及片段延展,为理解生成影像的时间连续性提供研究节点。
 查看大图 ↗
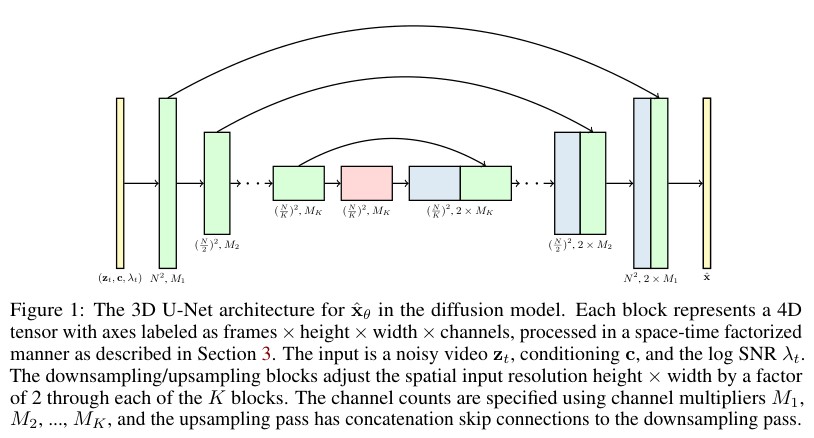
图1:原论文的时空分解3D U-Net架构。 来源为v2,图像版本与论文首次公开日分别记录。
Ho, Jonathan; Salimans, Tim; Gritsenko, Alexey; Chan, William; Norouzi, Mohammad; Fleet, David J. · original paper / arXiv · 原论文图文与所引作品权利归各自权利人;研究引用不代表开放授权,转载权利待独立复核。
资料出处 · Video Diffusion Models ↗档案研究说明
视频扩散模型把图像去噪扩展到时间维度,并研究图像与视频联合训练及片段延展,为理解生成影像的时间连续性提供研究节点。
ANTI-AI ARCHIVE · 修订 2026-10-03
论文研究了什么
论文将图像扩散架构扩展到视频,通过图像与视频联合训练改善优化,并提出在空间与时间上延展视频的条件采样方法。研究分别报告文本条件生成、视频预测和无条件生成的实验;这些任务不能当作同一能力。
本节依据: 视频扩散模型
与生成艺术史的关系
编者解释:此处的历史问题是连续画面如何形成,而不仅是一张图如何运动。它为比较后来的视频服务提供方法背景,也使镜头时长与时间一致性成为可以讨论的制作条件。
本节依据: 视频扩散模型
阅读边界与版本
摘要与原论文选页可支持方法概述,未复现实验;不把作者的优先性表述直接写成艺术史上的“首次”。
本节依据: 视频扩散模型
正文引用资料
核读arXiv摘要、署名和版本记录,以及原论文第3页所选图页;未全文审查证明、未复现实验。
核读arXiv摘要、署名和版本记录,以及原论文第3页所选图页;未全文审查证明、未复现实验。 正文与译文使用 AI 辅助,尚未经独立人工审校;分节引文标明依据,不代表已独立验证全部史实。
带着问题继续阅读
Video Diffusion Models:对照Make-A-Video的方法、控制或评价条件。
Video Diffusion Models:对照Stable Video Diffusion的方法、控制或评价条件。
日期与版本记录
节点标注日期:2022-04-07 · 来源记录的历史日期:2022-04-07
时间线采用arXiv首次公开日,不以会议发表、模型上线或2026-10-03补录日替代。正文及图像参照v2;该版日期见原文版本记录。
以上日期属于历史事件或资料所记版本,不是本站页面的上线日期;保留原有日期精度与待核事项。
原始资料与进一步阅读
以下链接通往来源的论文、文章、机构或会议页面。外部原文的语言以来源为准。
核读arXiv摘要、署名和版本记录,以及原论文第3页所选图页;未全文审查证明、未复现实验。
出处、翻译与核验状态
档案节点 #172 · 研究论文首次公开;方法、评估与制作条件
研究资料与补充出处 · 1
2022年以来重要论文补录与去重资料 · 核读arXiv摘要、署名和版本记录,以及原论文第3页所选图页;未全文审查证明、未复现实验。 · 001
原记日期: 2022-04-07
视频扩散模型 ↗
Video Diffusion Models
站内说明依据所列研究资料撰写,非外链全文译本;AI 辅助翻译,待独立人工审校。
已按条目所列范围核读官方资料;核读范围与待复核事项见来源说明。
引用本节点
ANTI-AI ARCHIVE. 视频扩散模型. 艺术史节点 #172. https://salondesrefuses.cn/zh/art-history/324
引用具体史实时,请同时引用上方原始资料,并补充你的访问日期。本站说明不是外链全文译本。
相邻节点按时间顺序排列,不意味着二者存在直接影响或因果关系。