
导读
PixArt-α 将 diffusion transformer、预训练文本编码器和训练效率作为核心问题,成为 2024 DiT/flow image model 浪潮的重要开放研究节点。
 查看大图 ↗
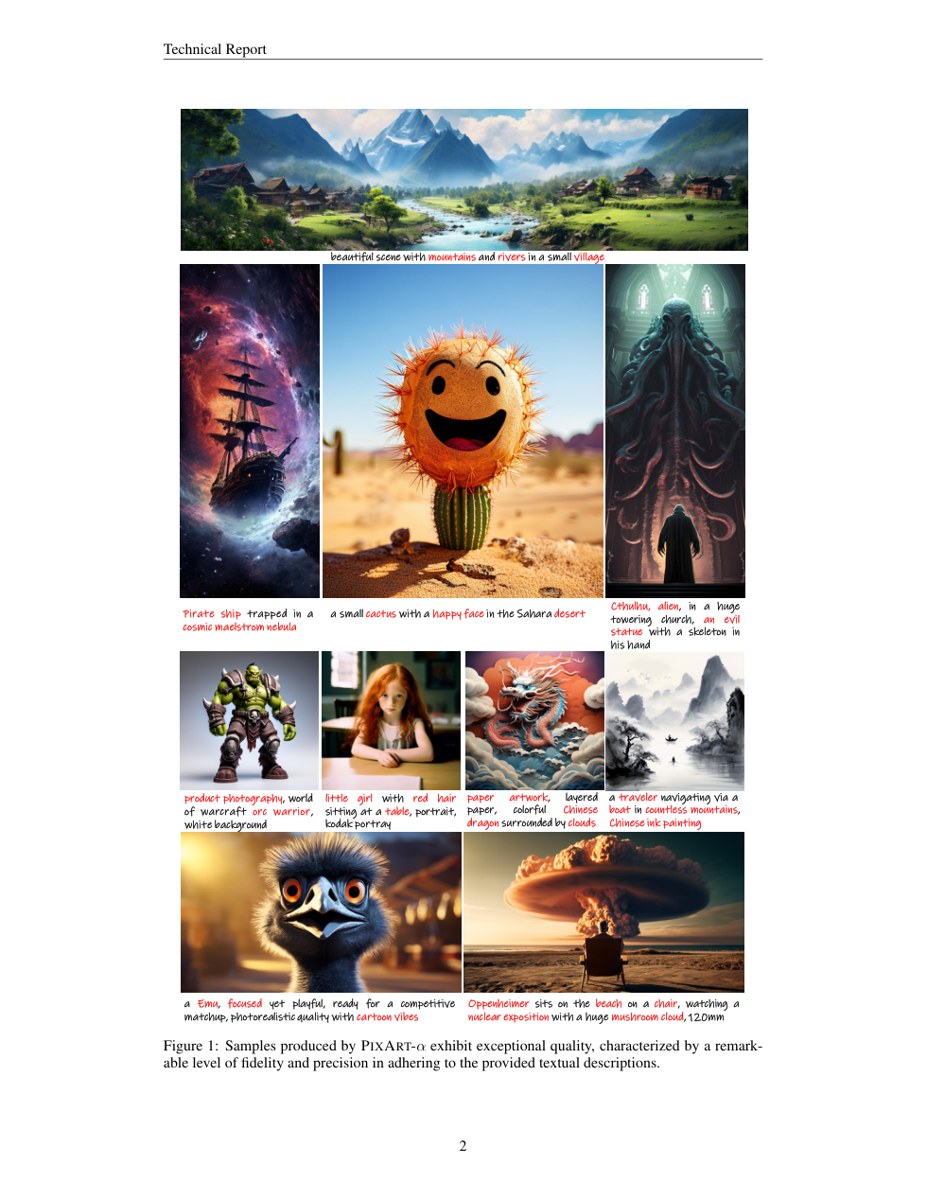
所链接文献 PDF 的第 2 页,保留原图与原语言。页面版本以来源文件为准;后来的修订或重印日期不替代节点的历史日期。
Junsong Chen et al. · 原文献 · 图像权利归原权利人;不视为开放许可
资料出处 · PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis ↗档案研究说明
将训练成本、描述密度与图像质量放在同一问题中。
ANTI-AI ARCHIVE · 修订 2026-10-02
研究方法与具体变化
PixArt-α把像素依赖、文字—图像对齐和审美质量的训练拆成不同阶段,并在扩散Transformer中加入文字条件。研究强调信息密集的图像描述,使用视觉语言模型补充标注。论文的成本比较针对特定训练设置,不能据此推算所有模型的环境负担。
在艺术史中的位置
这个节点揭示视觉模型不只依赖图像数量,也依赖图像被怎样描述。自动标注会把另一个模型的分类和语言选择带入训练,因此“数据质量”本身也包含需要分析的文化判断。
正文引用资料
核读作者或会议页面的摘要与版本记录;未通读全部证明或复现实验。
本篇按引用范围扩写档案说明;研究解释不应被理解为原作者的自述或已证实的因果影响。 正文与译文使用 AI 辅助,尚未经独立人工审校;分节引文标明依据,不代表已独立验证全部史实。
带着问题继续阅读
比较本条与CycleGAN:非配对图像转换之间的制作方法、控制方式或展示语境。
比较本条与LAION-5B:大规模图文数据集之间的制作方法、控制方式或展示语境。
日期与版本记录
节点标注日期:2023-09 · 来源记录的历史日期:2023-09
以上日期属于历史事件或资料所记版本,不是本站页面的上线日期;保留原有日期精度与待核事项。
原始资料与进一步阅读
以下链接通往来源的论文、文章、机构或会议页面。外部原文的语言以来源为准。
PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis
https://arxiv.org/abs/2310.00426
当前引用地址
出处、翻译与核验状态
主线节点 #208 · 历史节点
研究资料与补充出处 · 2
AI 艺术谱系研究母版 · p. 34 · 118
原记日期: 2023-09
PixArt-α:高效扩散 Transformer ↗
PixArt-α: Fast Training of Diffusion Transformer for Photorealistic Text-to-Image Synthesis
生成式视觉发布编年研究母版 · p. 15 · R076
原记日期: 2023-09
PixArt-α:高效扩散 Transformer ↗
Chen et al. — PixArt-α
站内说明依据所列研究资料撰写,非外链全文译本;AI 辅助翻译,待独立人工审校。
母版研究论述与日期尚待独立核验。
引用本节点
ANTI-AI ARCHIVE. PixArt-α:高效扩散 Transformer. 艺术史节点 #208. https://salondesrefuses.cn/zh/art-history/118
引用具体史实时,请同时引用上方原始资料,并补充你的访问日期。本站说明不是外链全文译本。
相邻节点按时间顺序排列,不意味着二者存在直接影响或因果关系。