
本档案提供中英文研究文本。部分译文可能使用 AI 辅助,且可能尚未经独立人工审校。请结合原语言来源核对。
本批收录一键拦截及按抓取收费私测两个节点。
来源网页摘录 · 2026-10-01
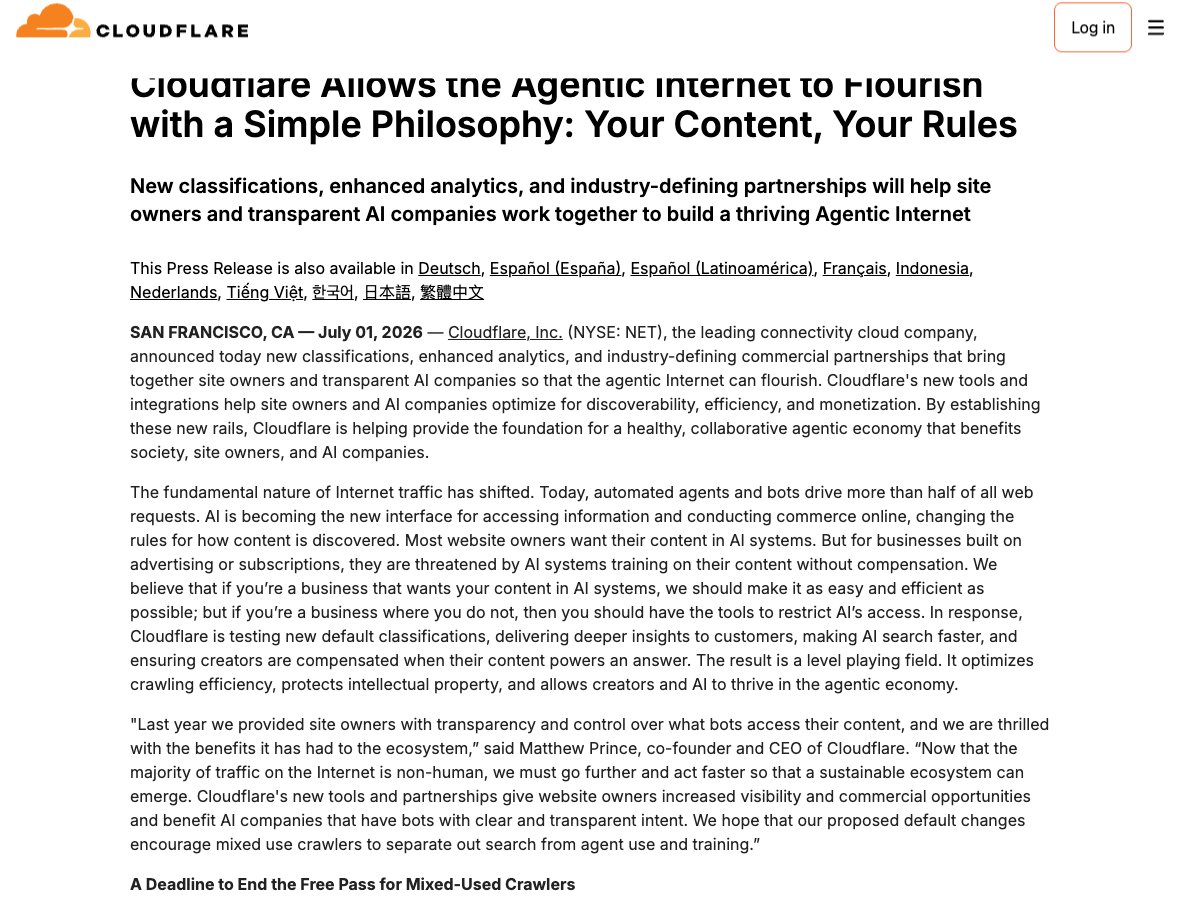 查看大图 ↗
《Cloudflare公布区分搜索、代理访问及训练的爬虫默认规则计划》来源网页摘录,截取于 2026 年 10 月 1 日。保留网页中的原语言排版;不是事件发生当日的网页快照。
来源:Cloudflare;权利归原始权利人。
资料出处 · Cloudflare公布区分搜索、代理访问及训练的爬虫默认规则计划 ↗日期范围指已收录节点,并非完整案例起止时间。
研究注
start_date 为本批最早收录节点,不声称是整个争议的起点。案例状态是编辑研究状态,非诉讼状态。
案例编年Case chronology
Cloudflare 发布 AI 爬虫一键拦截功能
Cloudflare 宣布向包括免费套餐在内的客户提供 AI Scrapers and Crawlers 开关。
Cloudflare 公布 Pay Per Crawl 私测
Cloudflare 发布 Pay Per Crawl 私测说明,允许网站运营者对选定 AI 爬虫设置访问价格。
Cloudflare公布区分搜索、代理访问及训练的爬虫默认规则计划
Cloudflare宣布拟于9月15日调整部分客户默认规则:含广告页面允许搜索但阻止训练与代理访问,并限制不能区分用途的混合爬虫。客户可更改设置。
研究线索Research question
比较拒绝、收费与平台依赖;并非把供应商归入反 AI 阵营。
关联文献Related documents
DOC-0407Cloudflare公布区分搜索、代理访问及训练的爬虫默认规则计划来源Sources
相关案例Related cases
引用本条目Cite this record
ANTI-AI ARCHIVE. “Cloudflare / AI 爬虫访问控制.” case-0002. 访问时请注明本页链接与访问日期。