
导读
MusicGen通过单一语言模型组织多路压缩音乐词元,以文字或旋律为条件生成音乐,把表示方式与听觉控制纳入生成艺术时间线。
 查看大图 ↗
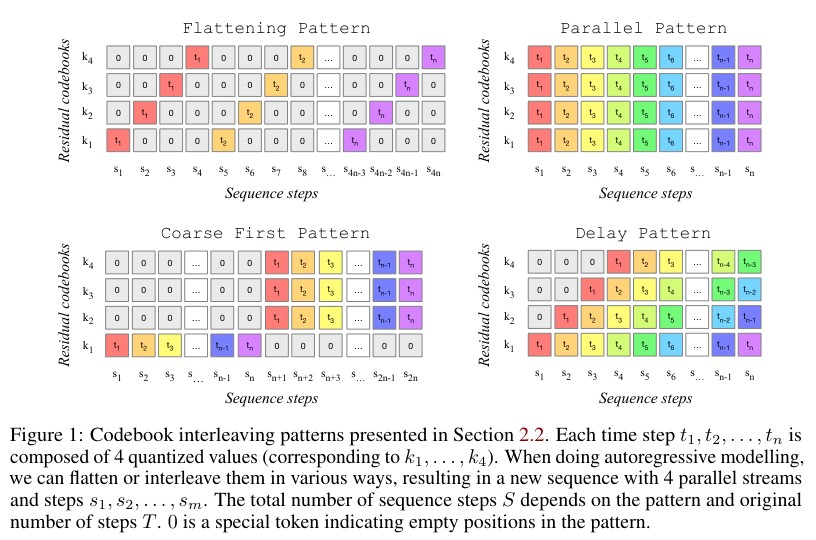
图1:MusicGen的音乐词元交错排列方案;声音结果见作者试听入口。 来源为v3,图像版本与论文首次公开日分别记录。
Copet, Jade; Kreuk, Felix; Gat, Itai; Remez, Tal; Kant, David; Synnaeve, Gabriel; Adi, Yossi; Défossez, Alexandre · original paper / arXiv · 原论文图文与所引作品权利归各自权利人;研究引用不代表开放授权,转载权利待独立复核。
资料出处 · Simple and Controllable Music Generation ↗档案研究说明
MusicGen通过单一语言模型组织多路压缩音乐词元,以文字或旋律为条件生成音乐,把表示方式与听觉控制纳入生成艺术时间线。
ANTI-AI ARCHIVE · 修订 2026-10-03
论文研究了什么
论文将音乐表示为多路离散词元,通过交错安排让单阶段Transformer处理这些流。研究比较文本描述与旋律条件,并结合自动指标和人类听评检验生成结果。
本节依据: MusicGen:简单且可控的音乐生成
与生成艺术史的关系
编者解释:旋律输入使声音创作不必完全从文字开始。这个节点适合比较已有音乐材料、描述性语言和生成片段之间的关系,原站试听也是理解作品可能性的必要材料。
本节依据: MusicGen:简单且可控的音乐生成
阅读边界与版本
生成片段与完整作曲、演奏和出版流程有别;论文的听评结果不解决训练授权或输出权利问题。
本节依据: MusicGen:简单且可控的音乐生成
正文引用资料
核读arXiv摘要、署名和版本记录,以及原论文第2页所选图页;未全文审查证明、未复现实验。
核读arXiv摘要、署名和版本记录,以及原论文第2页所选图页;未全文审查证明、未复现实验。 正文与译文使用 AI 辅助,尚未经独立人工审校;分节引文标明依据,不代表已独立验证全部史实。
带着问题继续阅读
MusicGen:对照AudioLDM:潜空间扩散的文本到声音生成的方法、控制或评价条件。
MusicGen:对照音乐 AI 公平授权原则的方法、控制或评价条件。
MusicGen:对照Jukebox的方法、控制或评价条件。
日期与版本记录
节点标注日期:2023-06-08 · 来源记录的历史日期:2023-06-08
时间线采用arXiv首次公开日,不以会议发表、模型上线或2026-10-03补录日替代。正文及图像参照v3;该版日期见原文版本记录。
以上日期属于历史事件或资料所记版本,不是本站页面的上线日期;保留原有日期精度与待核事项。
原始资料与进一步阅读
以下链接通往来源的论文、文章、机构或会议页面。外部原文的语言以来源为准。
核读arXiv摘要、署名和版本记录,以及原论文第2页所选图页;未全文审查证明、未复现实验。
出处、翻译与核验状态
档案节点 #235 · 研究论文首次公开;方法、评估与制作条件
研究资料与补充出处 · 1
2022年以来重要论文补录与去重资料 · 核读arXiv摘要、署名和版本记录,以及原论文第2页所选图页;未全文审查证明、未复现实验。 · 019
原记日期: 2023-06-08
MusicGen:简单且可控的音乐生成 ↗
Simple and Controllable Music Generation
站内说明依据所列研究资料撰写,非外链全文译本;AI 辅助翻译,待独立人工审校。
已按条目所列范围核读官方资料;核读范围与待复核事项见来源说明。
引用本节点
ANTI-AI ARCHIVE. MusicGen:简单且可控的音乐生成. 艺术史节点 #235. https://salondesrefuses.cn/zh/art-history/342
引用具体史实时,请同时引用上方原始资料,并补充你的访问日期。本站说明不是外链全文译本。
相邻节点按时间顺序排列,不意味着二者存在直接影响或因果关系。