
导读
Midjourney 从静态图像扩展到图像生成视频,并将其置于交互世界模型的探索方向中。此处的 V1 是视频模型,不是早期图像模型的 V1。
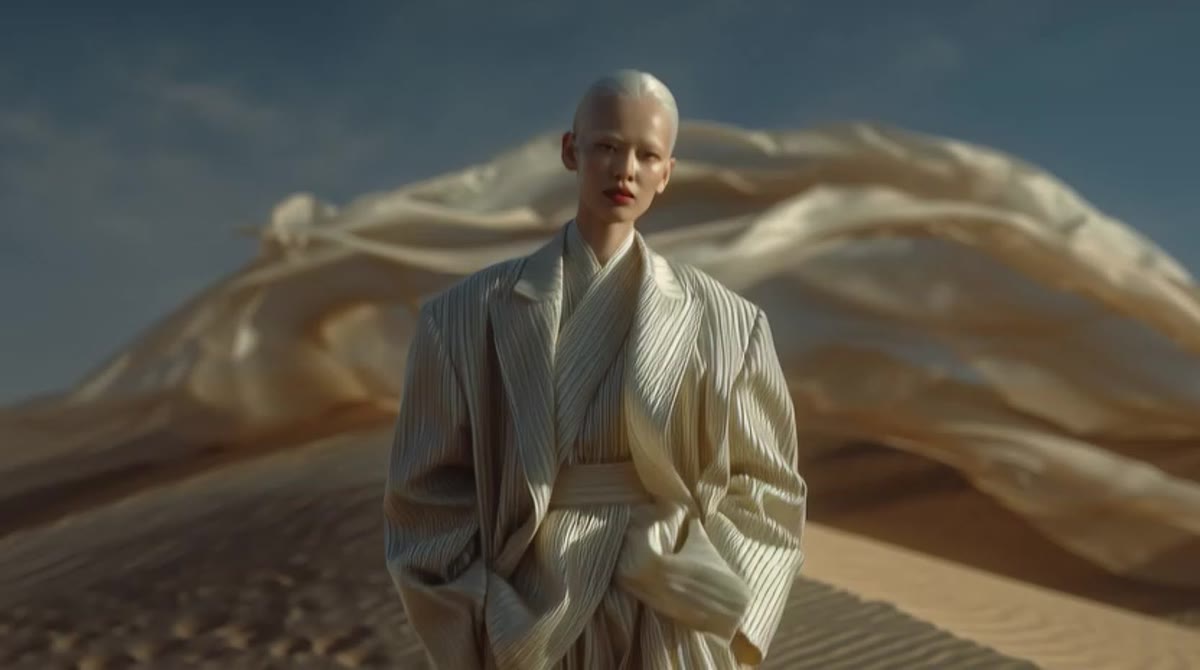 查看大图 ↗
Midjourney V1 视频模型官方发布演示,第 2 秒截帧。保留其人物与沙漠场景的原始生成画面。
Midjourney · 原始图像与文献权利归各自权利人
资料出处 · Introducing Our V1 Video Model ↗档案研究说明
从选定的静态图像出发构造短时运动。
ANTI-AI ARCHIVE · 修订 2026-10-02
发布内容与使用方式
Midjourney于2025年6月18日发布V1视频模型。其入口围绕图像的Animate操作展开:用户可采用自动运动描述或自行指定,并在低、高运动选项之间选择;也可上传自己的起始图像。公告说明通过多次延长继续片段。这里的基本单位是从图像出发的短片段,而非一次生成完整长篇影片。
本节依据: Midjourney V1 视频模型:资料依据
创作史中的变化
选定一幅图像先确定构图和视觉氛围,随后才协商运动,这与从文字开始的工作顺序不同。高运动与图像稳定之间的取舍也属于创作决定。要理解作品,除最终片段外,还应保存起始图像、运动提示及延长的选择。
本节依据: Midjourney V1 视频模型:资料依据
正文引用资料
核读官方公告的发布范围与演示说明;厂商性能评价不作为独立测试结论。
本篇按引用范围扩写档案说明;研究解释不应被理解为原作者的自述或已证实的因果影响。 正文与译文使用 AI 辅助,尚未经独立人工审校;分节引文标明依据,不代表已独立验证全部史实。
带着问题继续阅读
比较本条与Pika 2.1 与 2.2 系列之间的制作方法、控制方式或展示语境。
比较本条与Google Flow之间的制作方法、控制方式或展示语境。
日期与版本记录
节点标注日期:2025-06-18 · 来源记录的历史日期:2025-06-18
以上日期属于历史事件或资料所记版本,不是本站页面的上线日期;保留原有日期精度与待核事项。
原始资料与进一步阅读
以下链接通往来源的论文、文章、机构或会议页面。外部原文的语言以来源为准。
V1 Video Model
https://updates.midjourney.com/introducing-our-v1-video-model/
当前引用地址
此处是档案的双语研究摘要;外链为原始来源,不代表发布方提供了中英双语全文。
出处、翻译与核验状态
主线节点 #299 · 模型 / 产品
研究资料与补充出处 · 1
生成式视觉发布编年研究母版 · p. 32 · R172
原记日期: 2025-06-18
Midjourney V1 视频模型 ↗
V1 Video Model
站内说明依据所列研究资料撰写,非外链全文译本;AI 辅助翻译,待独立人工审校。
母版研究论述与日期尚待独立核验。
引用本节点
ANTI-AI ARCHIVE. Midjourney V1 视频模型. 艺术史节点 #299. https://salondesrefuses.cn/zh/art-history/204
引用具体史实时,请同时引用上方原始资料,并补充你的访问日期。本站说明不是外链全文译本。
相邻节点按时间顺序排列,不意味着二者存在直接影响或因果关系。